Opus 5.5 y GPT-6 el mismo día: la pelea ya no es por el modelo más grande
El 22 de septiembre de 2026, Anthropic y OpenAI lanzaron modelos nuevos con menos de dos horas de diferencia. No era otra ronda de «el más potente del mundo». Era otra cosa: bajar el costo de usar inteligencia de punta sin renunciar al rendimiento.
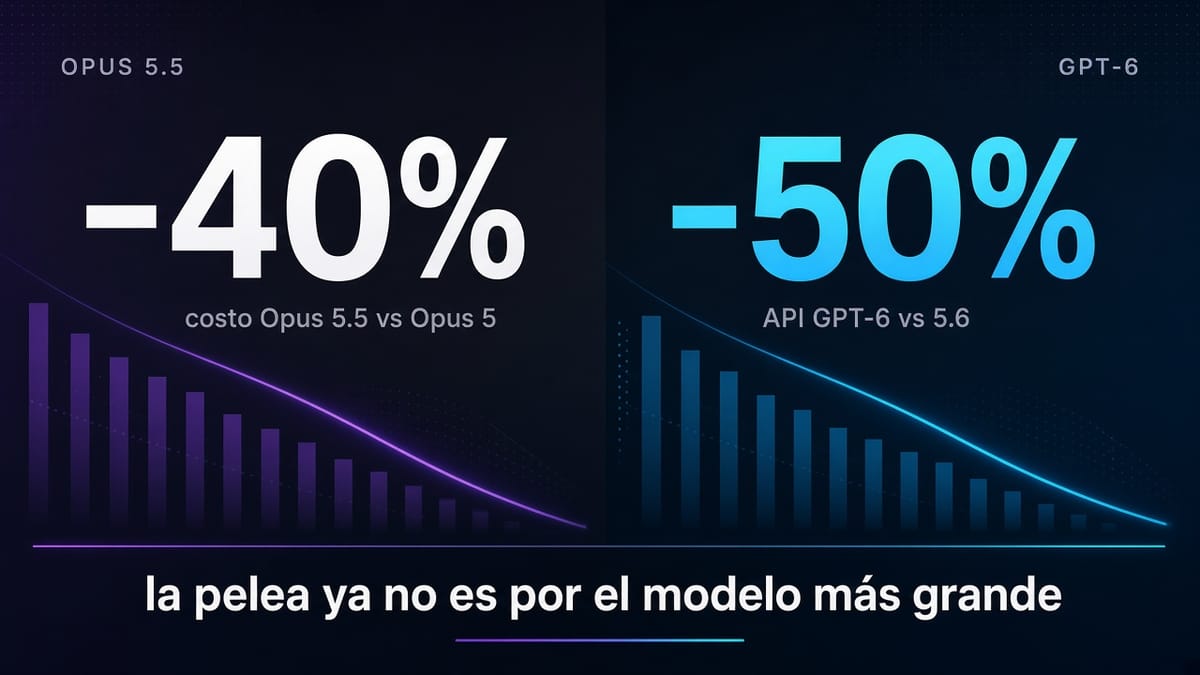
Anthropic presentó Claude Opus 5.5, el primero de la familia Claude 5.5. Según la compañía, rinde a un nivel comparable a Claude Fable 5.1 en la mayor parte del trabajo y cuesta alrededor de un 40% menos que Opus 5 en cargas típicas. El precio por token bajó un 20% frente a Opus 5 (entrada a 4 dólares y salida a 20 dólares por millón), y las lecturas de caché —que concentran buena parte del gasto en agentes y coding— cayeron un 60%, a 0,20 dólares por millón. Además, Anthropic afirma que genera salida más de un 30% más rápido.
OpenAI, por su lado, amplió la generación GPT-6 con Sol y Luna actualizados. Sol apunta a tareas complejas como coding; Luna, a trabajo de alto volumen con meta clara (resúmenes, extracción, preguntas rápidas). Lo que más pesó en el anuncio: el costo de API queda a la mitad respecto de la serie 5.6, gracias —dicen— a mejoras en caché e inferencia. También afirman menos errores factuales y de coding: en su evaluación interna, GPT-6 Sol comete cerca de la mitad de los errores de su predecesor, acercándose a la confiabilidad de Astra a menor costo.
TechCrunch notó el detalle del timing: Opus 5.5 salió unos 90 minutos antes que Sol y Luna. La carrera ya no se mide solo en benchmarks de punta; se mide en quién hace más accesible esa punta.
CIO encuadró bien lo que está pasando. Charlie Dai (Forrester) habla de una carrera prolongada por la relación precio-rendimiento, impulsada por eficiencia de inferencia, mejor caché y optimización de modelos, y agravada porque las capacidades empiezan a converger. Sanchit Vir Gogia (Greyhound Research) va más lejos: no es una «guerra de precios» clásica, sino una pelea por convertirse en la vía por defecto con la que las empresas compran inteligencia.
Para quien decide stack, el mensaje práctico es otro. El precio por token importa, pero no alcanza. Dai recomienda mirar costo por resultado de negocio —fiabilidad, latencia, tasa de tareas completadas— y validar con cargas propias, no solo con tablas de marketing. Gogia insiste en el costo total por resultado aceptado y conforme a políticas. Y ambos recuerdan que bajar la API no mata la demanda de IA privada o híbrida: soberanía de datos, seguridad e IP siguen empujando arquitecturas mixtas.
Anushree Verma (Gartner) suma el contexto competitivo: los modelos de uso general se perciben cada vez más como intercambiables, y los labs pelean cuota con agresividad, a menudo respaldados por hiperescala y capital. Eso empuja una carrera a la baja en inferencia estándar —y obliga a las empresas a comparar rendimiento, costo y opciones de despliegue entre proveedores, no a casarse con un solo nombre.
En resumen: el 22 de septiembre no coronó un ganador de «el modelo más grande». Marcó el momento en que Anthropic y OpenAI hicieron explícito que la pelea siguiente es eficiencia. Quien compra o integra debería dejar de preguntar solo «¿cuál es el mejor?» y empezar a preguntar «¿cuál me da el resultado que necesito, al costo y con el control que aguanto?».